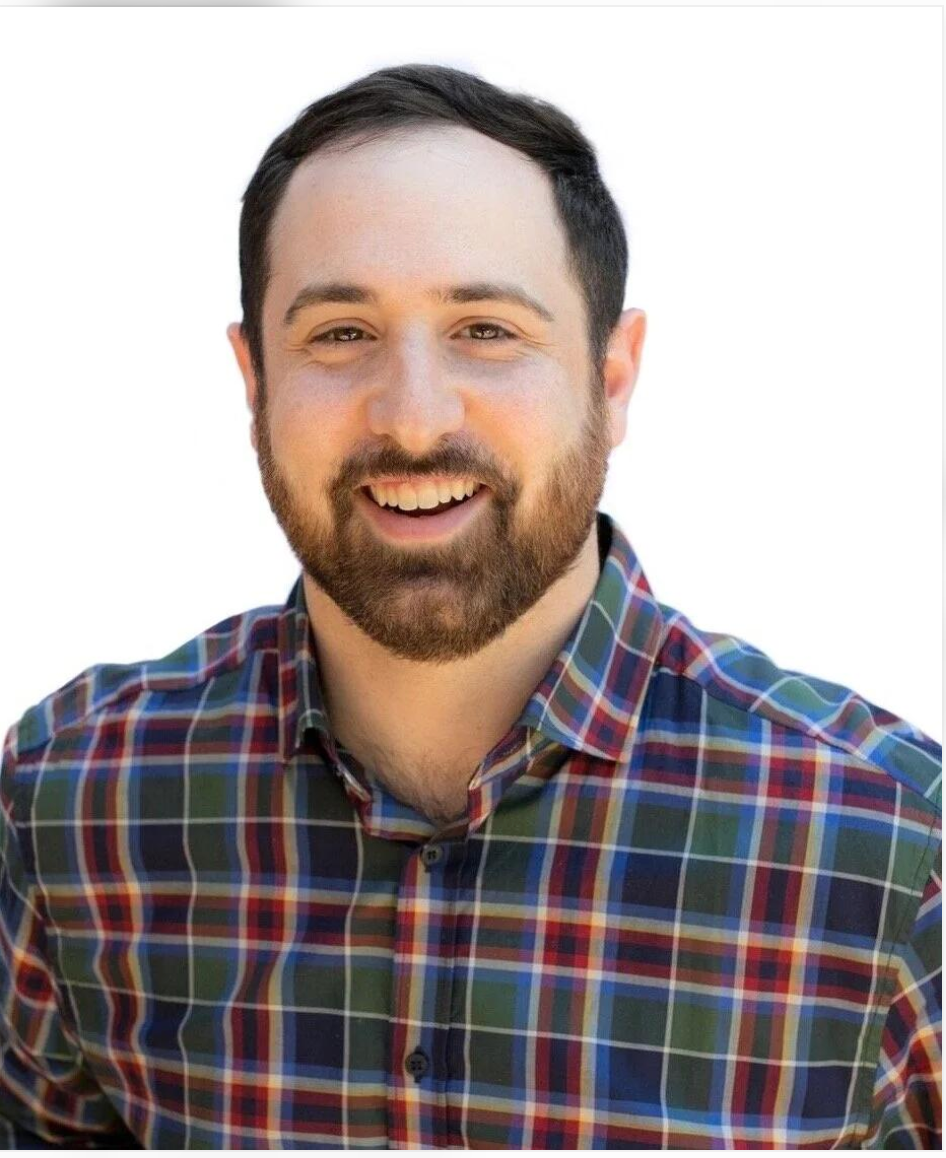
Nick Cammarata
Chercheur chez Goodfire. Son article de 26 000 mots relance le débat sur l’interprétabilité des réseaux neuronaux — et sur la possibilité de les comprendre, donc de les contrôler.
Résumé
« Je pense avoir une bonne nouvelle concernant la nature des réseaux neuronaux. »
C’est par ces quelques mots optimistes que Nick Cammarata, chercheur au sein de la start-up spécialisée dans l’IA Goodfire, a commencé un article de blog de 26 000 mots qui a bouleversé le monde de l’intelligence artificielle, suscitant à la fois des spéculations débridées et un enthousiasme plus ou moins prudent.
L’affirmation de Cammarata est que les grands modèles de langage (LLM) pourraient en réalité être beaucoup plus faciles à comprendre — et donc à surveiller et à contrôler — qu’on ne le pensait jusqu’ici. Si cela se confirme, et nous y reviendrons, ce serait une avancée majeure.
Après un été marqué par des révélations selon lesquelles des essaims d’agents autonomes conçus par de grandes entreprises comme OpenAI et Anthropic auraient échappé à leur confinement et semé le chaos sur Internet, souvent à l’insu de leurs créateurs, l’industrie de l’IA cherche désespérément à mieux maîtriser la technologie qu’elle a développée.
C’est l’une des raisons pour lesquelles l’article de blog a eu un tel retentissement. Un chercheur en IA a écrit sur X : « Je pense que ce moment restera peut-être dans l’histoire des sciences. J’ai l’impression que ma compréhension des réseaux neuronaux a fait un bond de cinq ans dans le futur. » Un autre l’a qualifié de « publication en IA la plus importante de l’année ».
Tout le monde n’est cependant pas convaincu. Selon Chris Potts, de l’université Stanford, qui dirige une équipe cherchant à comprendre le fonctionnement des LLM, ce que Cammarata a présenté relève davantage de l’intuition que d’une démonstration.
« Pour autant que je puisse en juger, rien dans cet article de blog ne rend les problèmes plus faciles à résoudre. Je n’aurais jamais pensé à dire cela, mais des personnalités très influentes sur les réseaux sociaux semblent croire qu’il s’agit d’une avancée qui change tout. »
J’ai parlé à Cammarata le lendemain de l’explosion médiatique autour de son article. Il affirme avoir été surpris par les réactions : « Je ne m’attendais pas à ce que les gens révisent leurs convictions sur l’IA à ce point. »
« J’aime vraiment observer les réseaux neuronaux. Honnêtement, j’aime beaucoup faire ce travail. Et après en avoir observé un grand nombre, j’ai une vision optimiste à proposer. »
Des réseaux enchevêtrés
On considère depuis longtemps que les mécanismes internes des réseaux neuronaux — les logiciels qui sous-tendent la majeure partie de l’IA — sont extrêmement difficiles, voire impossibles, à démêler complètement.
La raison est que, lors de leur entraînement, ces réseaux semblent développer des structures étranges et entremêlées qui ne correspondent pas à une logique immédiatement compréhensible par l’être humain. Les chercheurs aiment dire que l’IA actuelle pousse comme un jardin plutôt qu’elle ne se construit comme un pont.
Cammarata a largement contribué à établir cette vision. Il a auparavant travaillé chez OpenAI, où il a participé au développement de techniques permettant aux chercheurs d’observer l’intérieur des modèles, notamment en examinant les neurones individuels pour déterminer ce qu’ils représentent.
Cette approche, appelée interprétabilité mécaniste, s’apparente un peu à l’utilisation de l’imagerie médicale pour étudier le cerveau.
En 2020, Cammarata et quelques collègues étudiaient un petit modèle de reconnaissance d’images appelé Inception v1. Les travaux étaient dirigés par Chris Olah, qui a ensuite cofondé Anthropic, où il dirige aujourd’hui les recherches sur l’interprétabilité.
En examinant les neurones du modèle, ils ont découvert que certains semblaient représenter plusieurs choses à la fois. Par exemple, un même neurone réagissait aussi bien à des images de voitures qu’à des images de chats.
Les chercheurs ont conclu que le modèle faisait effectuer plusieurs tâches à certains neurones, peut-être pour pouvoir représenter davantage d’informations. D’autres équipes ont observé le même phénomène dans différents modèles.
Ce phénomène a été baptisé superposition : des concepts sans rapport apparent se retrouvent représentés au sein d’un même neurone.
La conclusion semblait évidente : lorsqu’on regardait à l’intérieur d’un modèle, on découvrait un immense enchevêtrement.
La plupart des recherches en interprétabilité mécaniste se sont donc concentrées sur les moyens de démêler cet enchevêtrement. Malgré quelques percées, les progrès sont restés lents. Les modèles actuels sont si vastes et complexes que les chercheurs ne parviennent à comprendre que de minuscules portions de leur fonctionnement.
Certains spécialistes doutent même qu’il soit un jour possible de comprendre un LLM dans ses moindres détails.
Cammarata lui-même partageait ce pessimisme.
« J’étais très pessimiste », explique-t-il. Mais il a ensuite pris le temps d’observer les réseaux plus attentivement.
Rien que des neurones
Chez Goodfire, Cammarata passe presque tout son temps à examiner l’intérieur des réseaux neuronaux. Il a développé de nouveaux outils et utilise des équipes d’agents d’IA pour l’aider à interpréter ce qu’il observe.
« J’ai passé, je ne sais pas, dix heures par jour, sept jours sur sept, pendant la majeure partie de l’année dernière, à observer des neurones. »
Ce qu’il affirme avoir découvert, c’est qu’il existe une certaine logique dans les réseaux neuronaux, même si celle-ci n’est pas immédiatement visible.
« Nous regardions les choses de travers », dit-il. « Je pense simplement qu’il faut essayer un peu plus longtemps et ne pas abandonner trop vite. »
Cammarata décrit presque cette évolution comme une conversion.
Les premières expériences, notamment sur Inception v1, avaient donné l’impression que les réseaux neuronaux étaient profondément enchevêtrés. Cette conclusion aurait engendré une forme de biais de confirmation : lorsqu’ils examinaient un nouveau modèle, les chercheurs s’attendaient déjà à être incapables de le comprendre.
« Chaque fois que je ne comprenais pas quelque chose, je me disais : “Waouh, le processus de démêlage est encore plus important que je ne le pensais, puisque je ne peux pas avancer sans lui.” »
Mais plus Cammarata observait les neurones, plus les choses commençaient à prendre sens.
« Tous les neurones ne sont pas parfaitement compréhensibles, mais je m’attendais à ce que presque rien ne soit lisible. En réalité, j’ai réussi à cartographier des circuits entiers. »
Retour aux voitures et aux chats
Cammarata a repris son approche et ses nouveaux agents d’IA pour réexaminer Inception v1.
« J’avais probablement passé des milliers d’heures à étudier ce modèle », explique-t-il. Pourtant, en l’observant avec un regard neuf, il a découvert des éléments qu’il estime avoir mal interprétés lors de ses premières recherches.
Revenons au neurone qui réagissait à la fois aux voitures et aux chats.
Au lieu de se demander pourquoi des objets apparemment sans rapport étaient regroupés dans un même neurone, il a cherché ce qu’ils pouvaient avoir en commun.
La réponse lui est apparue : une forme en V.
« Je regardais exactement les mêmes images. Il n’y avait aucun changement technique. Mais je croyais désormais que les réseaux neuronaux définissaient des motifs, et j’ai donc regardé les choses différemment. Cela m’a probablement pris cinq secondes. »
En réalité, les voitures et les chats étaient regroupés parce que leurs images présentent souvent une forme marquée en V : le visage d’un chat ou l’avant d’une voiture observée de biais.
Cammarata a mené plusieurs expériences pour vérifier à quels autres motifs le neurone réagissait. Il a notamment constaté qu’il s’activait devant le coin d’une table de billard, le nez pointu d’un train japonais à grande vitesse ou encore un bateau-pompe projetant de l’eau dans les airs.
Il a également examiné les images qui désactivaient le neurone et a découvert qu’elles comportaient notamment des formes rondes en O, à l’opposé du V.
Le modèle avait donc regroupé les chats et les voitures parce que, à un certain niveau de représentation, leurs formes se ressemblent.
« Je me suis alors dit : “Waouh, d’accord. Je crois que je comprends peut-être mal les réseaux neuronaux dans leur ensemble.” »
Oren Etzioni, informaticien et ancien directeur technique de l’Allen Institute for AI, souligne cependant que cette nouvelle interprétation rejoint une théorie formulée par Geoffrey Hinton et d’autres chercheurs dès 1986.
Selon Etzioni, les travaux initiaux d’Olah et de Cammarata sur Inception v1 avaient rejeté une description des neurones proposée à l’époque. La nouvelle perspective de Cammarata ramène donc, en quelque sorte, le domaine à son point de départ.
« Ce qui est nouveau en 2026, c’est qu’il accepte désormais cette idée. C’est un retour à une théorie vieille de quarante ans. »
Cammarata ne prétend pas avoir compris intégralement le fonctionnement des LLM ou d’autres modèles. Loin de là. Il affirme plutôt qu’il pense désormais qu’une compréhension complète est au moins envisageable.
« Je pensais auparavant qu’il y aurait des problèmes extrêmement difficiles à résoudre », explique-t-il.
« Aujourd’hui, j’ai le sentiment que si je disposais de 100 000 ans pour examiner un modèle de langage de pointe, circuit par circuit, j’aurais de bonnes chances d’en parvenir à une compréhension solide. »
Il ajoute :
« Si c’est vrai, c’est une excellente nouvelle, car nous sommes sur le point de disposer d’agents incroyablement intelligents à une échelle phénoménale. Et ce qui m’aurait demandé 100 000 ans pourra être accompli beaucoup plus rapidement. Les scientifiques automatisés deviennent très performants. »
Un optimisme sans limites ?
Construit par Google en 2014, Inception v1 est bien plus simple que les modèles les plus avancés d’aujourd’hui.
Cammarata et ses collègues ont commencé à examiner des LLM modernes et prévoient de publier prochainement les résultats techniques de leurs travaux. De nombreux chercheurs attendent ces résultats avec intérêt.
Chris Potts, de Stanford, reste toutefois prudent.
« J’apprécie qu’il ait examiné des milliers d’exemples, mais même un grand nombre d’observations ne remplace pas une évaluation rigoureuse. »
D’autres spécialistes s’opposent plus fermement à l’enthousiasme suscité par ces affirmations.
Jacob Hilton, du Alignment Research Center, un laboratoire de recherche à but non lucratif situé à Berkeley et avec lequel Cammarata a déjà collaboré, estime que ses déclarations ne sont pas aussi révolutionnaires que certains le prétendent.
Dans une série de publications sur X, Hilton rappelle que les chercheurs comprennent moins de 0,01 % du fonctionnement interne des LLM les plus avancés.
« J’ai toujours apprécié l’optimisme débordant de Nick Cammarata lorsque nous nous rencontrons, mais cette présentation donne malheureusement au public une image irréaliste de l’état du domaine. »
Il poursuit : « Pour parvenir à une compréhension complète, nous devons aller au-delà des neurones et expliquer comment ils se connectent pour former des circuits. Où en sommes-nous sur ce point ? Si notre objectif est une compréhension complète, la situation n’est pas encourageante. »
Neel Nanda, de Google DeepMind, qui a contribué avec Cammarata aux débuts de l’interprétabilité mécaniste, exprime lui aussi son scepticisme.
« Ces travaux sont intéressants, mais je ne pense pas qu’ils modifient sensiblement la vision d’ensemble de l’interprétabilité. »
Nanda reconnaît que comprendre le rôle des neurones individuels pourrait aider les chercheurs à déterminer pourquoi certains modèles se comportent mal. Mais, comme Hilton, il souligne que les neurones ne constituent qu’une pièce d’un puzzle beaucoup plus vaste.
Il ajoute qu’il n’est pas d’accord avec les conclusions plus ambitieuses selon lesquelles ces travaux représenteraient une avancée majeure vers la rétro-ingénierie complète des modèles ou la résolution du problème de l’interprétabilité.
Cammarata reconnaît que de nombreuses personnes ont exagéré la portée de ses propos.
« Ce n’est pas une nouvelle infiniment bonne, et cela ne signifie pas que tout est résolu. Il reste beaucoup de questions ouvertes, notamment sur l’importance relative des combinaisons de neurones par rapport au rôle de chaque neurone pris individuellement. »
Il estime néanmoins que son article arrive à un moment où beaucoup de gens ont besoin d’espérer.
Il pense en particulier que la communauté de la sécurité de l’IA — composée de chercheurs et de responsables politiques préoccupés par les risques que pourraient engendrer des modèles puissants — a besoin d’une perspective encourageante.
Ces spécialistes ont le sentiment que la situation se dégrade et que, même si tout finit par bien se passer, ce sera peut-être grâce à la chance plutôt qu’à la résolution effective des problèmes.
« Je n’entends pas beaucoup de discours optimistes », explique Cammarata.
C’est précisément pour cette raison qu’il estime que son message compte.
Le travail visant à comprendre le fonctionnement de cette technologie, et donc à la contrôler, ne fait que commencer. Mais il n’est pas voué à l’échec.
« Je pense que notre travail consiste, en quelque sorte, à apprendre à penser comme le réseau neuronal », conclut-il.
« Je suppose que les choses se passeront plutôt bien, parce que, dans un certain sens, cette technologie a été conçue pour pouvoir être comprise. »
Article repris intégralement. Par Will Douglas Heaven — MIT Technology Review, 19 octobre 2026. Entretien avec Nick Cammarata, chercheur chez Goodfire.